A IA me abandonou, onde foi que eu errei? O guia de sobrevivência ao limite de tokens
Já se sentiu abandonado pela IA no meio de uma conversa? Saiba que não é você, é o limite de tokens. Descubra como evitar que sua inteligência artificial 'canse' de você e aprenda dicas simples para tornar suas interações mais longas, eficientes e econômicas. Afinal, quem nunca quis saber por que a IA desiste de você e como fazer ela durar mais? Domine a arte de conversar com máquinas sem ser bloqueado.

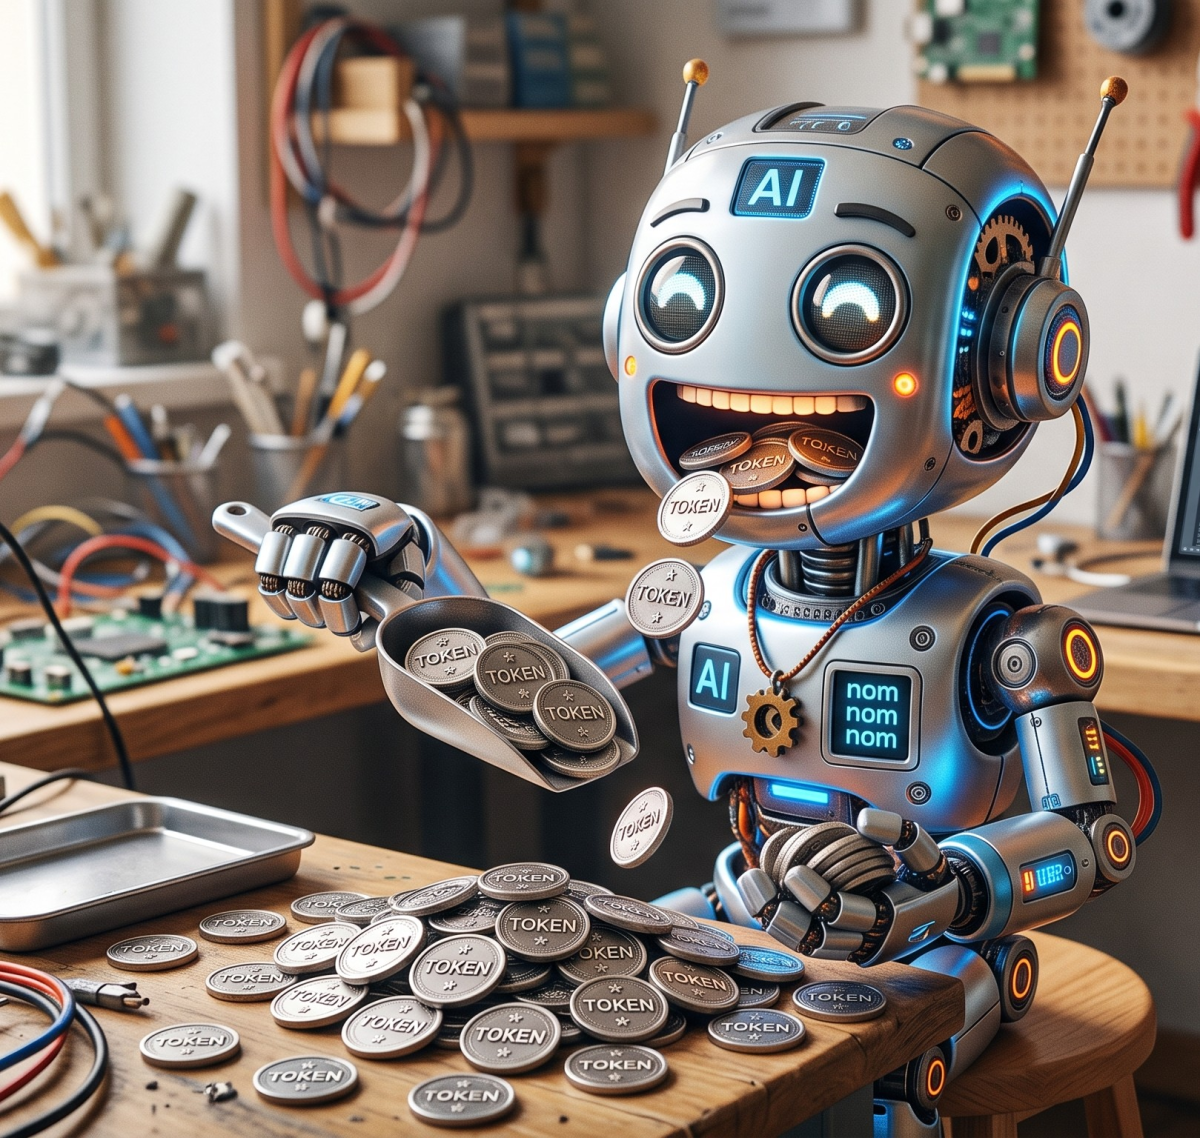
Se você é um usuário frequente de inteligências artificiais do tipo LLMs (Large Language Models) como ChatGPT, Gemini ou outras, provavelmente já passou pela experiência de no meio da conversa ela dizer para você: “Já cansei de você por hoje! Se quiser continuar, volte amanhã” (claro que ela não fala assim, mas a gente se sente assim, abandonado).
Mas por que isso acontece e como a gente poderia pelo menos tentar fazer com que a conversa seja um pouco mais longa?
Você já deve ter ouvido falar na palavra "token". Para quem não é programador ou especialista em tecnologia, o termo pode parecer estranho. No entanto, entender o básico sobre como as IAs leem e respondem é o segredo de ouro para, com algumas mudanças simples na forma como você gerencia suas conversas, controlar seus gastos, evitar limites de uso e tornar sua experiência mais eficiente.
O que é um Token?
Imagine que as IAs não leem palavras inteiras, mas sim "pedacinhos" de palavras, como se fossem sílabas ou pedaços de quebra-cabeça. Tokens são as menores unidades de texto que uma IA consegue processar de uma vez. Diferente de como lemos, palavra por palavra, as IAs quebram o texto em pedaços que podem ser palavras completas, partes de palavras, ou até mesmo caracteres individuais e espaços: os tokens. Por exemplo, a frase "Eu gosto de programar" pode ser dividida em 5 tokens, enquanto uma palavra complexa como "desconsideraria" pode virar 3 ou mais. A importância disso é que os tokens são a "moeda de processamento" das IAs.
Sempre que você envia uma mensagem (prompt), a IA precisa ler tudo o que você escreveu, os tokens de entrada, e então ela responde gerando tokens de saída. Se você paga por uma assinatura (ou usa uma API com cobrança por uso), tokens custam dinheiro real. Se usa a versão gratuita, tokens custam "tempo", porque quando você excede o limite, a IA bloqueia seu uso por algumas horas.
A regra básica é: quanto mais palavras e mais longa a conversa, mais tokens você gasta.
Mas existem estratégias para você, usuário comum, controlar esse gasto.
1. A Armadilha do Contexto: Comece Novas Conversas
Este é o erro número um dos usuários comuns. Você começa um chat pedindo uma receita de bolo. No mesmo chat, horas depois, você pede para a IA escrever um e-mail de trabalho. Depois, pede ajuda com um texto que você está escrevendo para um blog…
A cada nova pergunta que você faz naquela conversa a IA precisa ler a nova pergunta, as anteriores, e mais tudo o que ela já respondeu na conversa para poder gerar uma nova resposta com um contexto.
Para tentar ajudar você com aquele texto, a IA precisou reler toda a história da receita do bolo e do e-mail de demissão e seu pedido atual é um texto que não tem a ver nem com bolo nem com seu trabalho. Você está gastando tokens com informações que não têm relação com o seu pedido atual. E mais, além de gastar tokens, seu texto pode sair com alguma coisa relacionada a bolo de chocolate porque a IA entendeu que a receita de bolo que você pediu no início fazia parte do contexto da conversa.
Crie o hábito de iniciar um novo chat para cada assunto novo. Se a tarefa terminou (o e-mail foi escrito, a receita de bolo foi gerada), feche aquele chat e comece um em branco. Isso zera o "contexto" e garante que a IA só gaste tokens processando a nova pergunta.
2. Vá Direto ao Ponto
Muitas pessoas acham que precisam ser educadas com a IA, escrevendo textos longos como: "Olá, por favor, você poderia ser tão gentil de me ajudar a resumir este texto abaixo? Agradeço muito desde já."
A inteligência artificial não tem sentimentos; ela apenas processa texto. Cada palavra de polidez que você adiciona consome tokens de entrada e gera tokens de saída (já que ela costuma responder à educação com mais educação).
Use comandos curtos e objetivos.
Ruim: "Oi, tudo bem? Eu queria te pedir um enorme favor. Você consegue pegar esse texto que vou te mandar e fazer um resumo bem curto, com no máximo 3 linhas? Muito obrigado!"
Bom: "Resuma o texto abaixo em 3 linhas: [cole o texto]"
Ao limitar a resposta ("em 3 linhas", "em 150 palavras", "em tópicos"), você também controla os tokens de saída, que costumam ser os mais caros.
3. Edite o Prompt em Vez de Criar um Novo
Se a IA respondeu algo que não era exatamente o que você queria, não crie uma nova mensagem dizendo "Não, você entendeu errado, mude isso e aquilo". Como a IA tem que ler a sua nova mensagem como tokens de entrada, a resposta errada dela e formular uma nova resposta, o gasto de tokens dobra.
Como resolver: A maioria das plataformas (como o ChatGPT) permite que você clique no ícone de lápis (editar) ao lado da sua pergunta original. Altere a sua instrução diretamente na sua primeira mensagem e envie novamente. A IA vai apagar a resposta antiga e gerar uma nova, economizando o processamento desnecessário de uma "conversa de correção". Claro que os tokens de saída da resposta anterior, a errada, já foram gastos. Mas eles não serão mais usados como tokens de entrada para a próxima interação, gerando economia.
4. Cuidado com Documentos Gigantes
Muitas plataformas permitem fazer upload de PDFs, planilhas ou arquivos de texto. Isso é incrível, mas exige atenção. Se você faz o upload de um livro de 300 páginas e pergunta "Qual o tema do livro?", a IA não lê as 300 páginas de uma vez na sua memória imediata. Nos bastidores, ela faz uma busca interna para encontrar os trechos mais relevantes e então lê apenas esses pedacinhos para formular a resposta.
O problema é que, em documentos muito grandes, essa busca interna consome muito processamento da plataforma, pode demorar e, se o seu pedido for muito genérico, a IA pode acabar puxando trechos irrelevantes, gastando tokens à toa.
Como resolver: Ajude a IA a focar a busca. Se você sabe exatamente onde a informação está, diga isso a ela: "Baseado no documento anexo, leia apenas as informações da página 45 e me diga qual o valor do contrato". Se você não sabe onde está, peça primeiro um mapa: "Faça um resumo de 1 parágrafo de cada capítulo deste PDF". Assim, você usa a IA para criar um índice inteligente e, nos próximos pedidos, direciona a IA para o capítulo exato, poupando processamento e garantindo respostas muito mais precisas.
5. Forneça o Formato Desejado
Se você precisa de dados estruturados, diga exatamente como os quer. Pedir para a IA formatar tudo em uma tabela complexa ou em um texto corrido faz muita diferença no volume de saída. Se você só precisa dos nomes, peça apenas os nomes.
Exemplo prático: Em vez de perguntar "Quais são as vantagens e desvantagens da energia solar?", diga: "Liste 3 vantagens e 3 desvantagens da energia solar, apenas os tópicos, sem explicações detalhadas." Você cortou a resposta da IA (e seus tokens) pela metade.
6. Escolha a Ferramenta Certa para o Trabalho
Plataformas modernas como o ChatGPT, Gemini e Claude oferecem diferentes modelos de IA. Geralmente há um modelo "Pro/Avançado" e um modelo "Lite/Rápido".
Se você quer que a IA escreva um código complexo, analise um contrato jurídico ou crie um conto com rimas complexas, use o modelo avançado. Mas, se você só quer saber como conjugar o verbo "ir" no pretérito perfeito, ou pedir uma lista de compras básicas, use o modelo mais simples e rápido. Modelos mais simples têm menor custo por token (ou são gratuitos) e respondem em segundos.
7. Use Prompts Modelo (Templates)
Se você costuma fazer as mesmas tarefas repetidamente (ex: corrigir a gramática de e-mails, gerar descrições de produtos), crie um template curto no seu bloco de notas ou em ferramentas como o Gem do Gemini.
Em vez de escrever uma longa explicação de como você quer a correção toda vez, basta colar: "Corrija a gramática do texto abaixo, mantenha o tom informal e destaque as alterações em negrito: [texto]". Isso poupa não só o seu tempo, mas evita que você digite textos longos e desnecessários que consumirão tokens de entrada.
Otimizar o uso de tokens não é sobre aprender a programar ou entender a fundo a matemática por trás das redes neurais. É sobre organização e clareza de comunicação. O resultado será uma navegação mais fluida, respostas mais rápidas, economia no seu bolso e, o principal, a sensação de que você está realmente no controle da tecnologia, e não o contrário. Comece a aplicar essas dicas no seu próximo prompt e veja a diferença.
Qual é a sua reação?
 Como
2
 Não gosto
0
 Amor
1
 Engraçado
0
 Uau
0
 Triste
0
 Bravo
0





Comentários (0)